Journey to AI Engineering #1: The Project
A local-first expense tracker with on-device SLM and Whisper in the browser—stack, end-to-end flow, tradeoffs, and how the model improves from user corrections.
Akhir-akhir ini saya sedang eksplor titik tengah teknologi AI dan Software Engineering, yaitu AI engineering. Sederhananya, saya ingin lebih fokus mengintegrasikan model ke sistem yang live, sambil tetap mempertahankan kontrol pada bagian - bagian di sistemnya.
Deskripsi Produk
Karena itu, saya akan membangun aplikasi web sederhana agar pengguna bisa mencatat pengeluaran dengan lebih mudah. Aplikasi ini berupaya mempermudah proses dengan speech-to-text dan SLM yang membantu merekam serta menstandarkan informasi soal pengeluaran. Saya juga berencana memakai IndexedDB sebagai penyimpanan data di sisi pengguna, supaya catatan keuangan tetap privat dan local-first. Bagian penting lainnya adalah koreksi pengguna: jika SLM salah menafsirkan data, pengguna bisa memberi koreksi, koreksi itu juga bisa dipakai untuk melatih ulang model jika pengguna menyetujui.
Stack
- Aplikasi web memakai React, karena dominan SPA dan kebutuhan SEO relatif kecil.
- IndexedDB untuk penyimpanan data di sisi pengguna, seperti disebutkan di atas.
- Whisper untuk STT, agar implementasi lintas browser lebih mudah.
- SLM (saya pilih Llama 3.2 1B karena keseimbangan antara ukuran vs. kualitas untuk inferensi on-device lewat WebGPU).
- PostgreSQL untuk penyimpanan data global, terutama data pelatihan dan metadata model.
- R2 untuk object storage, untuk efisiensi biaya.
- Backend ditulis dengan Python, karena familiar dan cocok untuk orkestrasi data, pekerjaan yang terkait AI, serta sedikit soal API.
Alur end-to-end (high level)
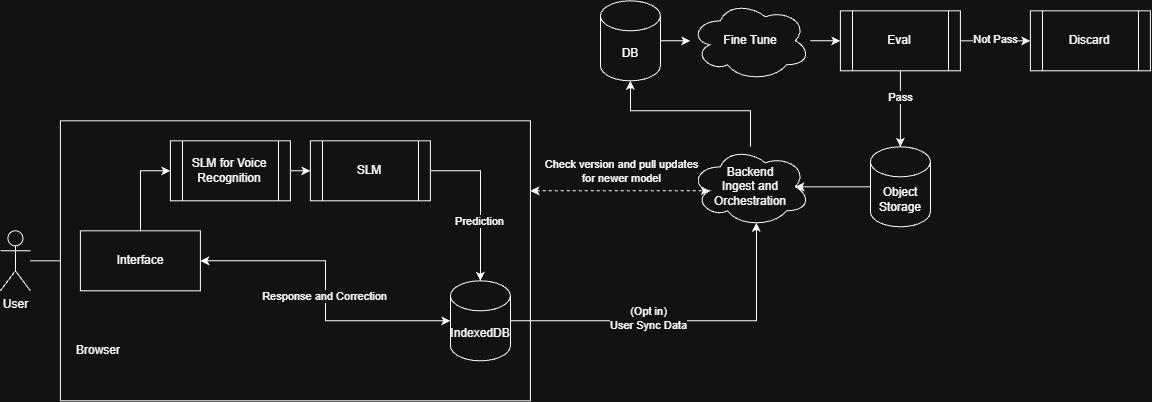
Keputusan desain dan tradeoff
- Stack yang familiar mempermudah development dan kolaborasi ke depan (jika ada). Sejauh ini, belum ada tantangan yang mendorong kita ke stack yang lebih rumit, setidaknya untuk scope saat ini.
- Prinsip local-first memberi pengguna kontrol langsung atas catatan keuangan mereka, sekaligus mengurangi latensi antar proses. Tradeoff-nya, konsumsi memori relatif besar dan beban load di awal. Saya punya beberapa ide mitigasi, seperti lazy loading, caching, dan kompresi (quantization). Nanti kita lihat apakah ini jadi masalah serius.
- Evaluasi sebelum perbaruan model. Ini memberi kontrol lebih baik atas siklus hidup model. Tradeoff-nya, perlu manusia dalam loop, menurut saya wajar demi kualitas model.
- Whisper dibanding Web API native. Beban muat awal dan memori lebih berat, tapi kita punya kontrol penuh atas bagian STT. Selain itu, Web API native belum didukung luas di berbagai browser (misalnya Firefox).
Yang akan saya lakukan berbeda jika skala membesar
Salah satu opsi yang layak dieksplorasi adalah memindahkan SLM ke server GPU khusus. Ini meningkatkan aksesibilitas bagi pengguna perangkat low-to-mid, tapi langsung mengorbankan jaminan privasi on-device yang menjadi inti desain proyek ini. Jalan tengah yang bisa kita coba, inferensi lokal tetap default, inferensi di server ditawarkan sebagai opt-in eksplisit untuk perangkat yang tidak kuat, mengikuti pola opt-in yang sudah dipakai untuk sinkronisasi data untuk pelatihan model.
Ada juga ide memperluas pipeline model agar versi localized SLM ikut membaik, baik STT maupun SLM interpreter. Jika pemakaian multibahasa benar-benar terjadi, memperluas pipeline ke model STT dan ekstraksi per bahasa mungkin melayani pengguna dengan lebih baik, meski pekerjaan tambahannya signifikan. Pekerjaannya adalah mencakup perawatan beberapa versi data dan proses evaluasi per bahasa. Bisa dilakukan, tapi sangat bergantung pada pola pemakaian saat live nanti.
Saya akan rutin menulis progres, kasus, dan rencana sepanjang development. Masukan dari kalian akan sangat saya hargai.
Cheers!