Journey to AI Engineering (Part 2): Finding an Indonesian ASR Model for Edge Deployment
My journey to finding, testing, and fine-tuning a speech recognition model for Indonesian financial conversations, with local inference as a design constraint.
Di bagian pertama, saya memperkenalkan expense tracker yang sedang saya bangun dan alasan saya ingin menjaga pemrosesannya tetap lokal.
Kali ini, saya ingin membahas satu masalah yang lebih spesifik: mencari model speech recognition yang bisa mentranskripsikan percakapan finansial berbahasa Indonesia dengan baik dan nantinya dijalankan sedekat mungkin dengan perangkat pengguna.
Konsepnya terdengar sederhana. Saya berbicara tentang sebuah pengeluaran, aplikasi mentranskripsikan ucapan tersebut, lalu komponen lain menginterpretasikan teksnya menjadi data finansial terstruktur.
Ternyata, membuat langkah pertama ini bekerja dengan baik saja sudah menjadi tantangan tersendiri.
Tantangan speech recognition untuk percakapan finansial berbahasa Indonesia
Speech recognition bukan sekadar memahami percakapan sehari-hari. Untuk expense tracker, hasil transkripsi harus mempertahankan detail seperti nominal, mata uang, dan informasi lain yang menentukan apakah sebuah transaksi dicatat dengan benar.
Misalnya, ada kalimat yang menyebut nominal Rp15.000. Kesalahan transkripsi pada nominal tersebut bukan sekadar kesalahan penulisan. Kesalahan itu bisa mengubah data finansial yang nantinya diproses oleh aplikasi.
Artinya, kualitas speech recognition secara umum belum cukup untuk mengukur keberhasilan model. Saya membutuhkan model yang bekerja dengan baik untuk bahasa dan konteks spesifik yang akan digunakan aplikasi.
Ada juga batasan deployment yang perlu diperhatikan: saya ingin menjalankan inference secara lokal, bukan bergantung pada layanan speech recognition eksternal.
Mencoba model yang sudah tersedia
Sebelum melatih model sendiri, saya ingin melihat kemampuan beberapa opsi yang sudah tersedia.
Saya mencoba beberapa kandidat:
- Chrome Web Speech API
- Whisper Tiny
- Whisper Small
- Model Whisper khusus bahasa Indonesia dari Hugging Face
- OmniCTC
Pengujian ini masih bersifat eksploratif, bukan benchmark formal. Saya menggunakan satu rekaman audio yang sama untuk membandingkan hasil transkripsi dan melihat perbedaannya. Pengujian ini cukup membantu untuk mempersempit pilihan, tetapi belum cukup untuk menyimpulkan bahwa satu model secara umum lebih baik daripada model lainnya.
Chrome Web Speech API menghasilkan transkripsi yang sangat baik dalam pengujian saya. Namun, hasil tersebut saja tidak membuatnya menjadi pilihan yang cocok untuk production. Proses recognition-nya dapat bergantung pada layanan eksternal, sehingga bertentangan dengan kebutuhan local-first yang saya tetapkan.
Model-model lainnya masih perlu membuktikan bahwa mereka bisa menangani jenis percakapan bahasa Indonesia yang saya butuhkan.
Whisper Small belum memberikan hasil yang cukup baik dalam pengujian awal saya. Saya juga mencoba model Whisper khusus bahasa Indonesia dari Hugging Face, tetapi model tersebut kesulitan mentranskripsikan contoh finansial sederhana yang mengandung frasa "15.000 ribu".
Pengalaman ini menunjukkan bahwa memilih model hanya karena mendukung bahasa Indonesia tidak menjamin model tersebut bisa mentranskripsikan percakapan finansial berbahasa Indonesia dengan benar.
Saya juga mengevaluasi OmniCTC sebagai kandidat lain. Hasil pengujian dan kompatibilitas deployment-nya masih perlu ditelusuri lebih lanjut, jadi saya belum ingin menarik kesimpulan tentang model ini.
Pada titik tersebut, terus mencari model siap pakai terasa kurang menjanjikan dibandingkan mencoba mengadaptasi model yang sudah ada.
Fine-tuning Whisper Small
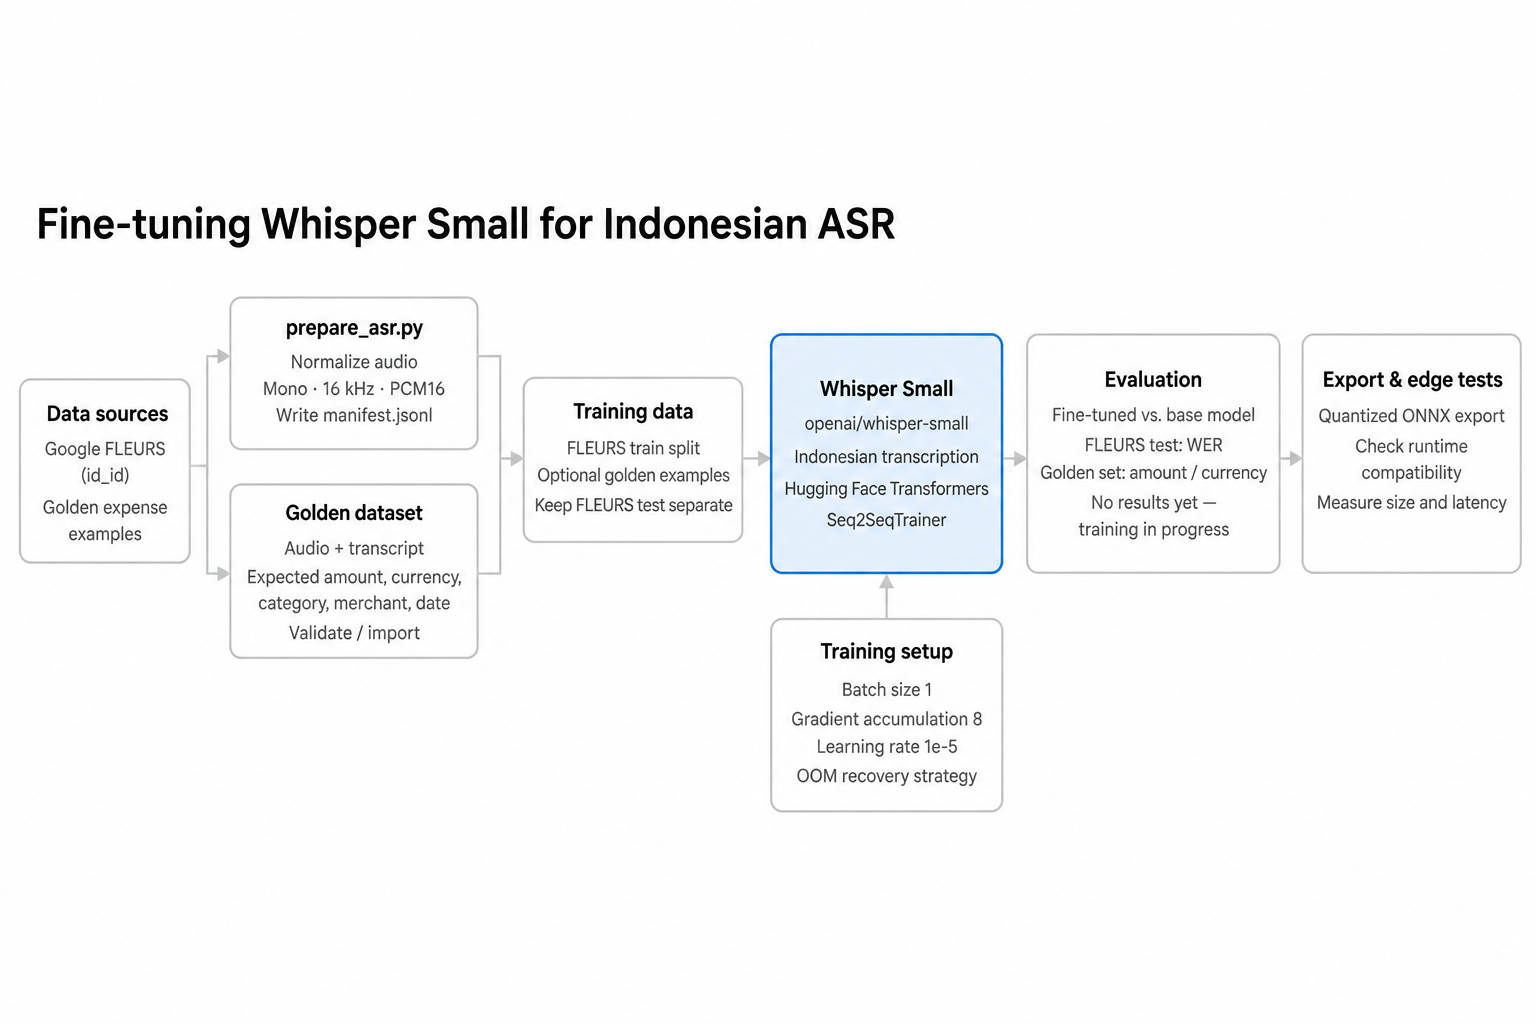
Saya memutuskan untuk melakukan fine-tuning Whisper Small untuk speech recognition bahasa Indonesia.
Proses training masih berjalan, jadi saya belum memiliki hasil yang bisa dilaporkan. Ini masih eksperimen yang sedang berlangsung, bukan klaim bahwa fine-tuning sudah berhasil menyelesaikan masalahnya.
Pipeline training menggunakan Hugging Face Transformers dengan checkpoint awal openai/whisper-small. Model dikonfigurasi untuk transkripsi bahasa Indonesia dan dilatih menggunakan pendekatan sequence-to-sequence.
Konfigurasi saat ini juga mempertimbangkan keterbatasan GPU memory selama training. Saya menggunakan batch size per device yang kecil dengan gradient accumulation. Pipeline ini juga memiliki strategi pemulihan ketika terjadi out-of-memory (OOM): encoder dibekukan terlebih dahulu sebelum dicoba untuk di-unfreeze kembali.
Semua ini merupakan keputusan implementasi, bukan bukti bahwa akurasi recognition sudah meningkat. Saya tetap perlu mengevaluasi model hasil fine-tuning sebelum memutuskan apakah upaya tambahan ini memang sepadan.
Menggunakan FLEURS sebagai dataset awal
Saya tidak ingin memulai dengan mengumpulkan dan mentranskripsikan dataset berukuran besar secara manual. Proses tersebut akan menjadi pekerjaan tambahan yang cukup besar, bahkan sebelum saya bisa mengevaluasi model.
Sebagai gantinya, saya menggunakan Google FLEURS, sebuah dataset speech multibahasa yang tersedia melalui Hugging Face. Untuk bahasa Indonesia, konfigurasi yang digunakan adalah id_id.
Script persiapan dataset saya memuat training split dan test split, mengonversi audio menjadi WAV mono dengan sample rate 16 kHz dan format PCM 16-bit, lalu menuliskan manifest yang berisi path audio dan transkripsinya.
Memisahkan test split merupakan hal penting. Saya ingin membandingkan model hasil fine-tuning dengan checkpoint Whisper Small asli menggunakan contoh pengujian yang sama, bukan hanya mengandalkan beberapa rekaman yang dipilih secara manual.
Namun, ada keterbatasan yang perlu diperhatikan. FLEURS berisi data percakapan umum, bukan dataset yang secara khusus dirancang untuk expense tracking. Peningkatan performa pada speech bahasa Indonesia secara umum belum tentu membuat model lebih andal dalam mengenali nominal transaksi.
Karena itu, saya membutuhkan dataset evaluasi kedua.
Golden dataset
Awalnya, saya berencana merekam diri sendiri saat mengucapkan banyak frasa yang berkaitan dengan keuangan, lalu menuliskan transkripsi yang benar secara manual.
Pendekatan tersebut akan menghasilkan contoh yang lebih dekat dengan kebutuhan aplikasi. Namun, mengumpulkan dan mentranskripsikan cukup banyak rekaman akan memakan waktu. Saya ingin tetap bisa melanjutkan eksperimen tanpa menjadikan pembuatan dataset sebagai keseluruhan pekerjaan.
Pendekatan yang saya gunakan sekarang adalah menjadikan FLEURS sebagai dataset awal, sambil membangun dataset yang lebih kecil dan spesifik untuk domain expense tracking. Saya menyebutnya golden dataset.
Golden dataset ini dirancang untuk berisi rekaman yang mencerminkan kebutuhan nyata aplikasi. Setiap contoh mencakup file audio, reference transcript, serta informasi terstruktur yang diharapkan, seperti nominal, mata uang, kategori, merchant, dan tanggal.
Saya juga memisahkan contoh menjadi dua kelompok: clear dan hard. Tujuannya bukan sekadar mengumpulkan rekaman, tetapi membangun kumpulan contoh yang konsisten untuk mengidentifikasi bagian mana yang sudah bekerja dengan baik dan bagian mana yang masih bermasalah.
Dengan pendekatan ini, saya memiliki dua cara evaluasi yang saling melengkapi:
- Speech recognition secara umum: Apakah fine-tuning meningkatkan kualitas transkripsi pada FLEURS test split yang tidak digunakan untuk training?
- Ketepatan untuk expense tracking: Apakah model mempertahankan informasi finansial yang benar-benar dibutuhkan aplikasi?
Saat ini, saya belum memiliki cukup hasil untuk mengetahui seberapa efektif pendekatan tersebut. Namun, memisahkan kedua tujuan evaluasi ini seharusnya memberikan gambaran yang lebih informatif dibandingkan hanya mengandalkan satu skor keseluruhan.
Training menggunakan Google Colab
Agar eksperimen lebih mudah dijalankan, saya menyiapkan Jupyter Notebook untuk Google Colab.
Notebook tersebut berfungsi sebagai wrapper untuk Python package yang saya buat, yaitu pasak. Operasi training dan pengolahan dataset berada di dalam package, sedangkan notebook menyediakan cara yang praktis untuk menjalankan workflow di lingkungan Colab.
Backend-nya dibagi menjadi beberapa tanggung jawab:
- Menyiapkan dataset ASR
- Melakukan fine-tuning Whisper Small
- Mengevaluasi checkpoint asli dan hasil fine-tuning
- Mengekspor model ke format ONNX terkuantisasi untuk eksperimen runtime selanjutnya
- Mengumpulkan, mengimpor, mengemas, dan memvalidasi contoh golden dataset
Saya ingin proses ini bisa diulang dengan cara yang konsisten. Jika saya mengubah dataset atau konfigurasi training, saya seharusnya bisa menjalankan kembali langkah persiapan dan evaluasi yang sama tanpa bergantung pada eksperimen manual.
Proses export ONNX juga menjadi bagian dari investigasi deployment. Model yang berhasil dilatih belum tentu cocok untuk inference di browser. Ukuran model, kompatibilitas runtime, penggunaan memori, dan latency tetap perlu diuji di lingkungan yang dituju.
Untuk saat ini, pipeline export tersebut masih menjadi fondasi untuk tahap berikutnya, bukan bukti bahwa deployment di browser sudah berhasil.
Apa yang masih perlu saya ketahui?
Ada tiga pertanyaan utama yang ingin saya jawab melalui eksperimen ini.
Pertama, apakah fine-tuning benar-benar meningkatkan recognition?
Saya akan membandingkan checkpoint hasil fine-tuning dengan model Whisper Small asli menggunakan FLEURS test split dan metrik word error rate (WER). Saya juga akan mengevaluasi golden dataset secara terpisah.
WER berguna untuk mengukur perbedaan hasil transkripsi, tetapi tidak sepenuhnya menggambarkan apakah nominal finansial berhasil dikenali dengan benar. Karena itu, evaluasi yang spesifik untuk domain expense tracking tetap diperlukan.
Kedua, apakah model menjadi lebih baik dalam mengenali percakapan finansial?
Model bisa saja mendapatkan skor transkripsi yang lebih baik secara umum tanpa menyelesaikan kesalahan yang paling penting bagi expense tracker. Saya perlu memeriksa hasil pengenalan nominal dan mata uang secara khusus, bukan langsung mengasumsikan bahwa WER yang lebih baik berarti data finansial yang lebih akurat.
Ketiga, apakah model bisa berjalan secara efisien di edge?
Model yang lebih akurat tetap bisa menjadi pilihan yang tidak praktis jika kebutuhan runtime-nya terlalu besar. Saya perlu mengevaluasi quantization, ukuran model, kompatibilitas browser, dan inference latency sebelum mengambil keputusan deployment.
Ketiga pertanyaan ini saling berkaitan, tetapi tidak bisa dianggap sama. Training yang berhasil hanyalah salah satu bagian dari solusi.
Status eksperimen saat ini
Sejauh ini, saya sudah mencoba beberapa opsi ASR yang tersedia, menyiapkan pipeline fine-tuning, dan memulai training Whisper Small menggunakan data bahasa Indonesia.
Pengujian awal membantu saya melihat kesenjangan antara kemampuan transkripsi bahasa Indonesia secara umum dan kebutuhan yang lebih spesifik untuk percakapan finansial. Golden dataset merupakan upaya saya untuk mengukur kesenjangan tersebut tanpa harus menunggu sampai memiliki dataset khusus berukuran besar.
Langkah berikutnya adalah menyelesaikan training dan mengevaluasi hasilnya. Setelah itu, saya baru bisa memutuskan apakah fine-tuning Whisper Small merupakan pendekatan yang layak dilanjutkan atau apakah saya perlu meninjau kembali pilihan model dan strategi deployment.
Untuk saat ini, saya memperlakukan proses ini sebagai investigasi engineering: mulai dari model yang sudah tersedia, identifikasi kasus yang gagal, bangun eksperimen yang bisa diulang, lalu gunakan hasilnya untuk menentukan langkah berikutnya.